Индекс NGRAM (HQbird): поиск подстроки с помощью LIKE '%...%' и CONTAINING
Индекс NGRAM находит строки по подстроке текстового значения, так что
WHERE col LIKE '%error 404%' не требует чтения всей таблицы.
Он использует разреженные n-граммы, метод поиска по коду GitHub
(реализация следует SereneDB).
Синтаксис
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Один столбец
CHAR,VARCHARилиBLOB SUB_TYPE TEXT, либо выражение с текстовым результатом или текстовым BLOB. - Допускаются любые наборы символов и порядки сортировки, в том числе нечувствительные к регистру и диакритике
(
UNICODE_CI,UNICODE_CI_AI) и порядки сортировки ICU (UNICODE,UTF8с локалью). - Частичный индекс (
WHERE) используется только если запрос содержит то же условие. - Не допускаются:
UNIQUE,DESCENDING, несколько столбцов,CONCURRENTLY, двоичные BLOB, массивы. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXработают как обычно.SHOW INDEXвыводитNGRAM INDEX,isql -xвыводитCREATE NGRAM INDEX.- ODS базы данных должен быть 13.1 (по умолчанию для Firebird 5).
Запросы, использующие индекс
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Шаблон должен содержать литеральную часть не менее 3 символов (между
%и_). Постоянный шаблон без такой части не использует индекс. Параметр без такой части даёт полное сканирование (результат при этом остаётся корректным). - Индекс может комбинироваться с другими индексами (
AND). LIKEвсегда проверяется повторно для каждой найденной строки, поэтому индекс никогда не меняет результат запроса.ORиз несколькихLIKEиспользует индекс для каждого из них.- Не используется для:
SIMILAR TO,STARTING WITH,=, диапазонов,IS NULL,ORDER BY,MIN/MAX.
Порядки сортировки
Ключи индекса строятся из той же канонической формы текста, которую сравнивает LIKE.
Поэтому при нечувствительном к регистру порядке сортировки LIKE нечувствителен к регистру, и индекс находит
те же строки:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
Каноническая форма порядков сортировки ICU зависит от версии ICU, как и для обычных
индексов. После смены библиотеки ICU перестройте индекс
(ALTER INDEX ... INACTIVE, затем ACTIVE).
CONTAINING
col CONTAINING 'x' нечувствителен к регистру. Он использует индекс NGRAM в двух случаях:
colимеет типUTF8с нечувствительным к регистру порядком сортировки Unicode (UNICODE_CI,UNICODE_CI_AI): индекс по самому столбцу;- любой другой порядок сортировки: индекс
COMPUTED BY (UPPER(col)). Запрос пишется как обычно,col CONTAINING 'x': оптимизатор сам находит индекс поUPPER.
Не используется для многобайтовых наборов символов, отличных от UTF8 и UNICODE_FSS
(например, SJIS_0208), с их порядками сортировки по умолчанию: там CONTAINING
сравнивает байты, а не символы.
Текстовые BLOB
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- Индекс содержит граммы всего BLOB любой длины. Сервер строит граммы
окнами по 64K символов и хранит только различные граммы, поэтому память для ключей
зависит от числа различных грамм, а не от размера BLOB. BLOB в многобайтовом
наборе символов читается целиком, как его читает
LIKE. - BLOB читается при вставке строки, при изменении BLOB и ещё раз
при сборке мусора, удаляющей старую версию.
UPDATEдругих столбцов сохраняет тот же BLOB и не читает его (также для индексаCOMPUTED BY (UPPER(body))). - Индекс содержит одну запись для каждой различной граммы строки. Длинные документы повторяют много грамм: исходные файлы Firebird дают 0.3 записи на символ, короткие строки — 1.4.
- Сначала загрузите данные, затем создайте индекс (см. «Размер и стоимость»).
Вывод плана:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Размер и стоимость
Измерено на строках исходного кода Firebird (953 000 строк, 27 миллионов символов):
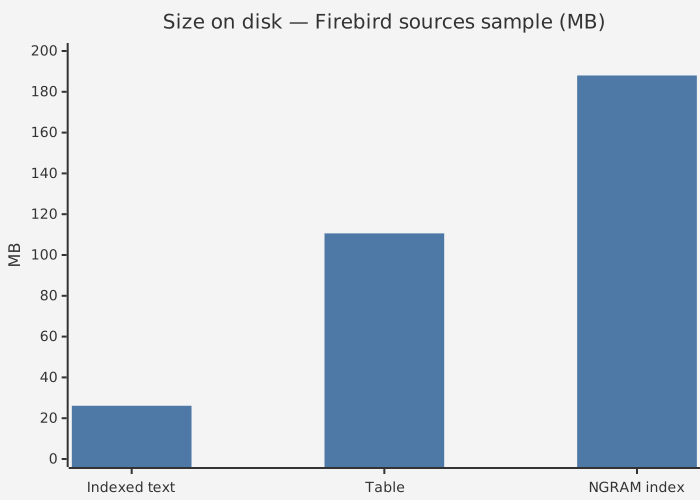
индекс 188 МБ (7,2× текста, 1,7× таблицы), построен за 16 с;
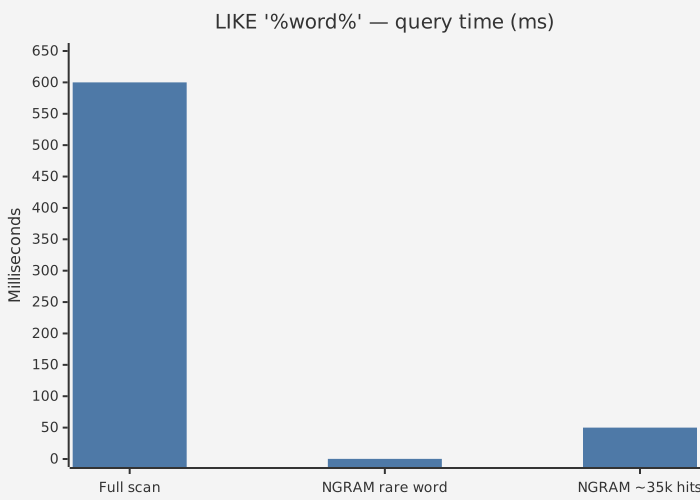
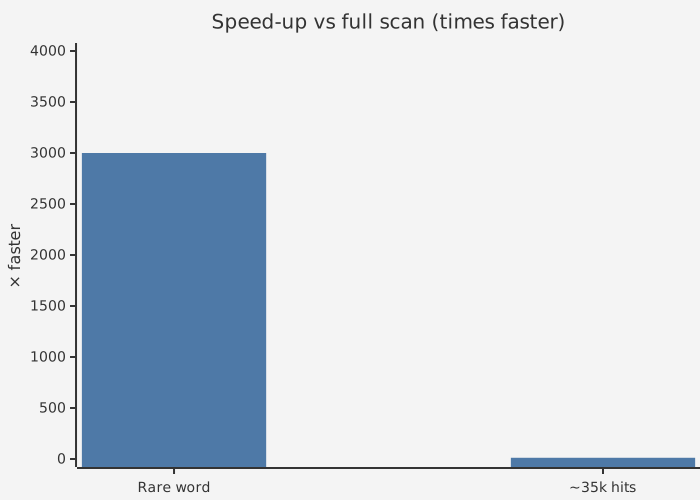
LIKE '%word%' в 12–4000 раз быстрее полного сканирования (от 0,2 мс для редких слов
до 50 мс для слова в 35 000 строк против 600 мс при сканировании).
С UNICODE_CI_AI сканирование в 6 раз медленнее (3,5 с), а индекс — нет:
LIKE и CONTAINING быстрее в 20–8000 раз.
Скорость запросов
| Случай | Время | Против полного сканирования |
|---|---|---|
| Полное сканирование таблицы | 600 мс | 1× |
| NGRAM, редкое слово | 0,2 мс | ~3000× |
| NGRAM, слово в ~35 000 строк | 50 мс | 12× |
Полное сканирование с UNICODE_CI_AI |
3,5 с | только сканирование в 6× медленнее |
Размер индекса
| Объект | Размер | Относительно |
|---|---|---|
| Индексируемый текст | ~26,1 МБ | 1× |
| Таблица | ~110,6 МБ | ~4,2× текста |
| Индекс NGRAM | 188 МБ | 7,2× текста, 1,7× таблицы |
| Построение индекса | 16 с | — |
Стоимость массовой загрузки
Для массовой загрузки создавайте индекс после загрузки или делайте его INACTIVE на время загрузки.
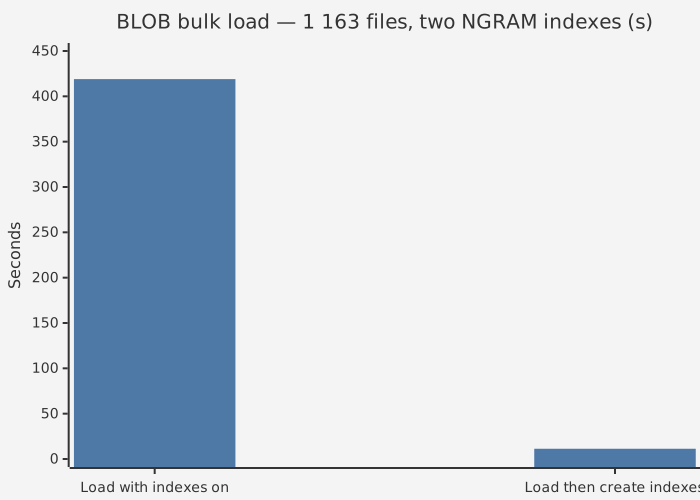
1 163 исходных файла (28 миллионов символов) в виде BLOB:
| Подход | Время |
|---|---|
| Загрузка с двумя активными индексами NGRAM | 419 с |
| Загрузка без индексов, затем создание обоих | 0,6 с + 10,7 с = 11,3 с |
- Около 1,4 записи индекса на символ текста (каждая запись — это 8-байтовый хеш грама и номер записи). Ожидайте индекс в несколько раз больше текста.
- Каждая вставка добавляет около 1,4 записи B-дерева на символ: вставки в таблицу с индексом NGRAM намного медленнее, чем без него. Целевая нагрузка — данные с преобладанием добавления (логи, сообщения, документы) с редкими обновлениями.
- Обновления вставляют только новые грамы. Старые грамы удаляются сборкой мусора, когда ни одной версии записи они больше не нужны.
- При создании индекса в каждой странице остаётся 5% свободного места, как и при
CONCURRENTLY. Грамы одной записи находятся во многих листовых страницах; без свободного места первые обновления после создания разделяют почти каждую листовую страницу. UPDATE, не изменяющий индексируемый столбец (для индекса по выражению — столбцы, которые использует выражение), вообще не вычисляет грамы.- При создании индекса все грамы сортируются: временное пространство — около 20 байт на грам.
ParallelWorkersускоряет создание.
Совместимость с серверами без поддержки NGRAM
Индекс хранится в ODS 13.1. Его условие (RDB$CONDITION_BLR) начинается с защитного
выражения, которое завершается ошибкой преобразования. Сервер без поддержки NGRAM
(стандартный Firebird 5.0.x, более старый HQbird):
- открывает базу данных;
SELECTдаёт правильные результаты и не использует индекс NGRAM; - отказывает в
INSERTиUPDATEв таблицу с ошибкойconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(таким образом индекс никогда не повреждается); - допускает
DELETEи sweep (индекс сохраняет лишние записи: это только стоимость по размеру); - не может активировать индекс.
Проверено со стандартным Firebird 5.0.4.1812 и HQbird 5.0.4.1773.
Сторонние инструменты могут показывать индекс как DESCENDING с предложением WHERE.
gbak создаёт резервные копии и восстанавливает индексы NGRAM (восстановление должно выполняться HQbird с поддержкой NGRAM).
Стандартное восстановление завершается ошибкой на индексе NGRAM по столбцу BLOB (attempt to index BLOB column)
и оставляет базу данных offline (gfix -online возвращает её в online без этого индекса).