NGRAM 索引(HQbird):使用 LIKE '%...%' 和 CONTAINING 进行子串搜索
NGRAM 索引通过文本值的子串来查找行,因此
WHERE col LIKE '%error 404%' 不需要读取整张表。
它使用稀疏 n-gram,即 GitHub 代码搜索的方法
(实现遵循 SereneDB)。
语法
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- 一个
CHAR、VARCHAR或BLOB SUB_TYPE TEXT列,或一个结果为文本 或文本 BLOB 的表达式。 - 允许任何字符集和排序规则,也包括大小写和重音不敏感的
(
UNICODE_CI、UNICODE_CI_AI)以及 ICU 排序规则(带区域设置的UNICODE、UTF8)。 - 部分索引(
WHERE)仅在查询具有相同条件时使用。 - 不允许:
UNIQUE、DESCENDING、多列、CONCURRENTLY、二进制 BLOB、数组。 ALTER INDEX ... ACTIVE | INACTIVE、SET STATISTICS INDEX、DROP INDEX照常工作。SHOW INDEX打印NGRAM INDEX,isql -x打印CREATE NGRAM INDEX。- 数据库 ODS 必须为 13.1(Firebird 5 的默认值)。
使用该索引的查询
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- 模式必须有一个至少 3 个字符的字面部分(位于
%和_之间)。 没有这种部分的常量模式不使用索引。 没有这种部分的参数会导致全表扫描(结果仍然正确)。 - 该索引可以与其他索引组合(
AND)。 - 对每个找到的行都会再次检查
LIKE,因此索引绝不会改变 查询的结果。 - 多个
LIKE的OR会为每个LIKE使用索引。 - 不用于:
SIMILAR TO、STARTING WITH、=、范围、IS NULL、ORDER BY、MIN/MAX。
排序规则
索引键由 LIKE 所比较的文本的同一规范形式构成。
因此,对于大小写不敏感的排序规则,LIKE 是大小写不敏感的,索引会找到
相同的行:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
ICU 排序规则的规范形式取决于 ICU 版本,与普通
索引相同。在更改 ICU 库之后,重建索引
(ALTER INDEX ... INACTIVE,然后 ACTIVE)。
CONTAINING
col CONTAINING 'x' 是大小写不敏感的。它在两种情况下使用 NGRAM 索引:
col是UTF8且具有大小写不敏感的 Unicode 排序规则(UNICODE_CI、UNICODE_CI_AI): 在列本身上建立索引;- 任何其他排序规则:一个
COMPUTED BY (UPPER(col))索引。照常编写查询,col CONTAINING 'x':优化器会自己找到UPPER索引。
不用于除 UTF8 和 UNICODE_FSS 之外的多字节字符集
(例如 SJIS_0208)及其默认排序规则:在那里 CONTAINING
比较的是字节,而不是字符。
文本 BLOB
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- 索引包含整个 BLOB 的 gram,无论长度如何。服务器以 64K 字符的窗口
生成 gram,并且只保留不同的 gram,因此键的内存
取决于不同 gram 的数量,而不是 BLOB 的大小。多字节
字符集中的 BLOB 会被整体读取,正如
LIKE读取它一样。 - 在插入行时、BLOB 被更改时,以及垃圾回收移除旧版本时
会再次读取 BLOB。对其他列的
UPDATE保持相同的 BLOB,不会读取它(对于COMPUTED BY (UPPER(body))索引也是如此)。 - 索引为行的每个不同 gram 保留一个条目。长文档会重复许多 gram:Firebird 的源文件每字符产生 0.3 个条目,短行则为 1.4 个。
- 先加载数据,然后创建索引(参见“大小和成本”)。
计划输出:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
大小和成本
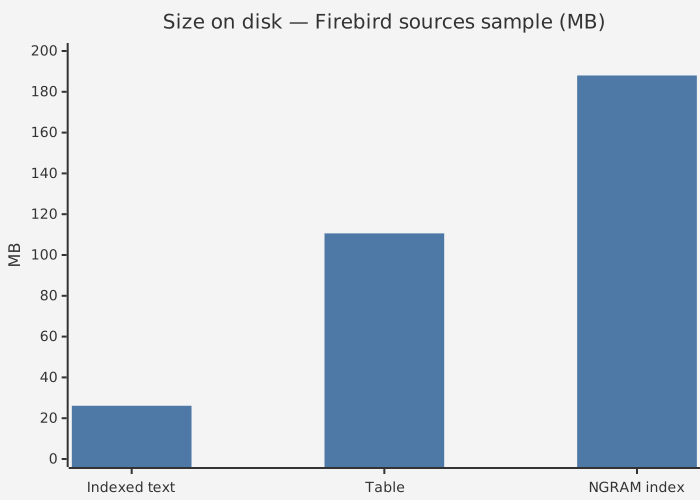
在 Firebird 源代码的行上测量(953 000 行,2700 万字符):
索引 188 MB(文本的 7.2 倍,表的 1.7 倍),构建耗时 16 秒;
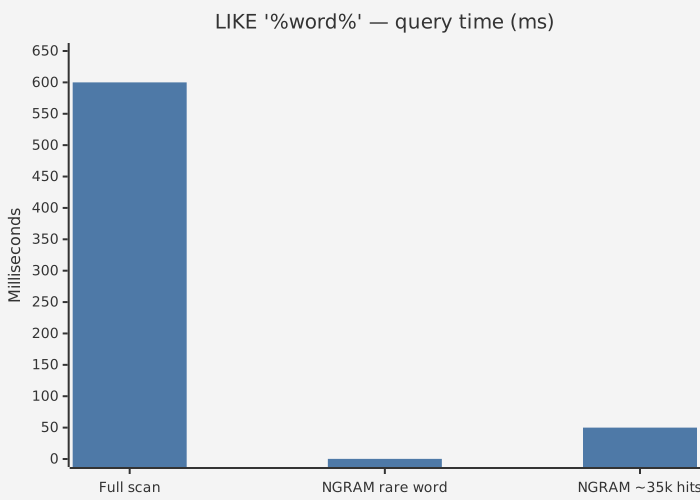
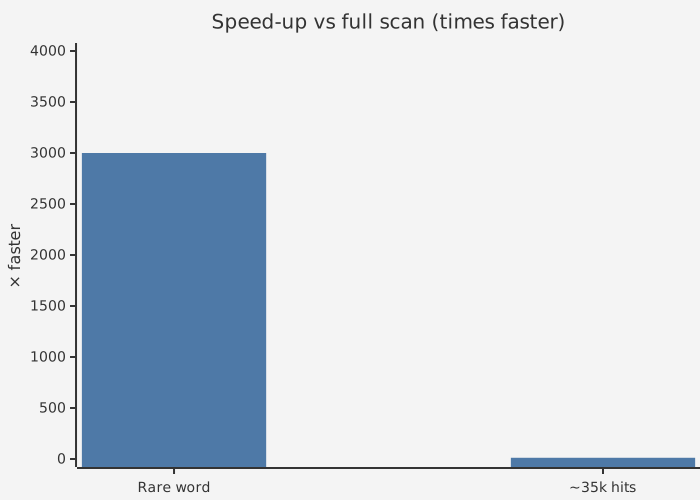
LIKE '%word%' 比全表扫描快 12 到 4000 倍(从稀有词的 0.2 毫秒
到出现在 35 000 行中的词的 50 毫秒,而扫描为 600 毫秒)。
使用 UNICODE_CI_AI 时,扫描慢 6 倍(3.5 秒),索引则不然:
LIKE 和 CONTAINING 快 20 到 8000 倍。
- 每字符文本约 1.4 个索引条目(每个条目是一个 8 字节的 gram 哈希 和一个记录号)。预期索引比文本大数倍。
- 每次插入每字符增加约 1.4 个 B-tree 条目:向带有 NGRAM 索引的表插入比没有索引时慢得多。目标是追加为主的数据 (日志、消息、文档),更新很少。
- 更新只插入新的 gram。旧的 gram 在没有记录版本 再需要它们时由垃圾回收移除。
- 索引创建在每个页面中留下 5% 的可用空间,正如
CONCURRENTLY所做的那样。一条记录的 gram 分布在许多叶子页面中;如果没有可用空间,创建后的第一次更新 几乎会分裂每个叶子页面。 - 不更改索引列(对于表达式索引:
表达式使用的列)的
UPDATE根本不会计算 gram。 - 对于批量加载,在加载后创建索引,或在加载期间将其设为
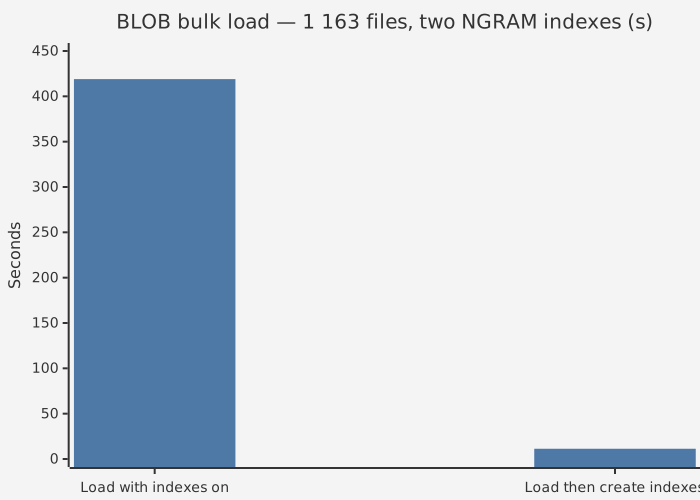
INACTIVE。 1 163 个源文件(2800 万字符)作为 BLOB:带两个 NGRAM 索引加载耗时 419 秒; 不带索引加载耗时 0.6 秒,然后创建两个索引耗时 10.7 秒。 - 索引创建会对所有 gram 排序:临时空间约为每个 gram 20 字节。
ParallelWorkers可加速创建。
与不支持 NGRAM 的服务器的兼容性
索引存储在 ODS 13.1 中。其条件(RDB$CONDITION_BLR)以一个会因转换错误而失败的
保护表达式开头。不支持 NGRAM 的服务器
(原版 Firebird 5.0.x、较旧的 HQbird):
- 打开数据库;
SELECT给出正确结果,并且不使用 NGRAM 索引; - 拒绝向该表执行
INSERT和UPDATE,并报错conversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(因此索引绝不会损坏); - 允许
DELETE和 sweep(索引保留额外条目:仅带来大小成本);
- 无法激活该索引。
已使用原版 Firebird 5.0.4.1812 和 HQbird 5.0.4.1773 测试。
第三方工具可能会将该索引显示为带有 WHERE 子句的 DESCENDING。
gbak 备份和还原 NGRAM 索引(还原必须由支持 NGRAM 的 HQbird 完成)。
原版还原在 BLOB 列上的 NGRAM 索引上失败(attempt to index BLOB column),
并使数据库处于离线状态(gfix -online 可在没有该索引的情况下使其上线)。