NGRAM-index (HQbird): substringzoeken met LIKE '%...%' en CONTAINING
Een NGRAM-index vindt rijen op basis van een substring van een tekstwaarde, zodat
WHERE col LIKE '%error 404%' niet de hele tabel hoeft te lezen.
De index gebruikt sparse n-grams, de methode van GitHub-codezoekopdrachten
(implementatie volgt SereneDB).
Syntaxis
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Eén kolom van het type
CHAR,VARCHARofBLOB SUB_TYPE TEXT, of een expressie met een tekst- of tekst-BLOB-resultaat. - Elk tekenset en elke collatie is toegestaan, ook hoofdletter- en accentongevoelig
(
UNICODE_CI,UNICODE_CI_AI) en ICU-collaties (UNICODE,UTF8met een locale). - Een partiële index (
WHERE) wordt alleen gebruikt als de query dezelfde voorwaarde heeft. - Niet toegestaan:
UNIQUE,DESCENDING, meerdere kolommen,CONCURRENTLY, binaire BLOBs, arrays. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXwerken zoals gebruikelijk.SHOW INDEXtoontNGRAM INDEX,isql -xtoontCREATE NGRAM INDEX.- De database-ODS moet 13.1 zijn (de standaard voor Firebird 5).
Queries die de index gebruiken
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- het patroon is een parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- met een index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- zie "CONTAINING" hieronder
- Het patroon moet een letterlijk deel van ten minste 3 tekens hebben (tussen
%en_). Een constant patroon zonder zo’n deel gebruikt de index niet. Een parameter zonder zo’n deel geeft een volledige scan (het resultaat is nog steeds correct). - De index kan worden gecombineerd met andere indexen (
AND). LIKEwordt voor elke gevonden rij opnieuw gecontroleerd, dus de index verandert nooit het resultaat van een query.ORvan meerdereLIKEgebruikt de index voor elk ervan.- Niet gebruikt voor:
SIMILAR TO,STARTING WITH,=, bereiken,IS NULL,ORDER BY,MIN/MAX.
Collaties
De indexsleutels worden gemaakt van dezelfde canonieke vorm van de tekst die LIKE vergelijkt.
Dus met een hoofdletterongevoelige collatie is LIKE hoofdletterongevoelig, en de index vindt
dezelfde rijen:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- vindt 'Café', 'CAFE', 'café'
De canonieke vorm van ICU-collaties is afhankelijk van de ICU-versie, net als bij gewone
indexen. Na een wijziging van de ICU-bibliotheek moet de index opnieuw worden opgebouwd
(ALTER INDEX ... INACTIVE, dan ACTIVE).
CONTAINING
col CONTAINING 'x' is hoofdletterongevoelig. Het gebruikt een NGRAM-index in twee gevallen:
colisUTF8met een hoofdletterongevoelige Unicode-collatie (UNICODE_CI,UNICODE_CI_AI): een index op de kolom zelf;- elke andere collatie: een index
COMPUTED BY (UPPER(col)). Schrijf de query zoals gebruikelijk,col CONTAINING 'x': de optimizer vindt deUPPER-index zelf.
Niet gebruikt voor multibyte-tekensets anders dan UTF8 en UNICODE_FSS
(bijvoorbeeld SJIS_0208) met hun standaardcollaties: daar vergelijkt CONTAINING
bytes, niet tekens.
Tekst-BLOBs
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- gebruikt note_body_up_ng
- De index bevat de grams van de hele BLOB, van elke lengte. De server maakt de grams
in vensters van 64K tekens en bewaart alleen unieke grams, dus het geheugen voor de sleutels
is afhankelijk van het aantal unieke grams, niet van de BLOB-grootte. Een BLOB in een multibyte-
tekenset wordt volledig gelezen, zoals
LIKEhem leest. - De BLOB wordt gelezen bij het invoegen van een rij, bij het wijzigen van de BLOB, en nog een keer
wanneer garbage collection de oude versie verwijdert. Een
UPDATEvan andere kolommen behoudt dezelfde BLOB en leest hem niet (ook voor een indexCOMPUTED BY (UPPER(body))). - De index heeft één vermelding voor elk uniek gram van een rij. Lange documenten herhalen veel grams: de bronbestanden van Firebird geven 0,3 vermeldingen per teken, korte regels 1,4.
- Laad eerst de gegevens en maak daarna de index (zie “Grootte en kosten”).
Plan-uitvoer:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Grootte en kosten
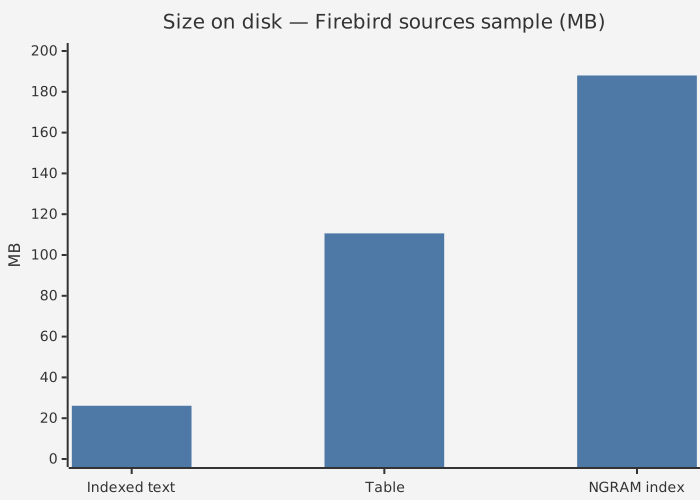
Gemeten op de regels van de Firebird-broncode (953 000 rijen, 27 miljoen tekens):
index 188 MB (7,2 x de tekst, 1,7 x de tabel), opgebouwd in 16 s;
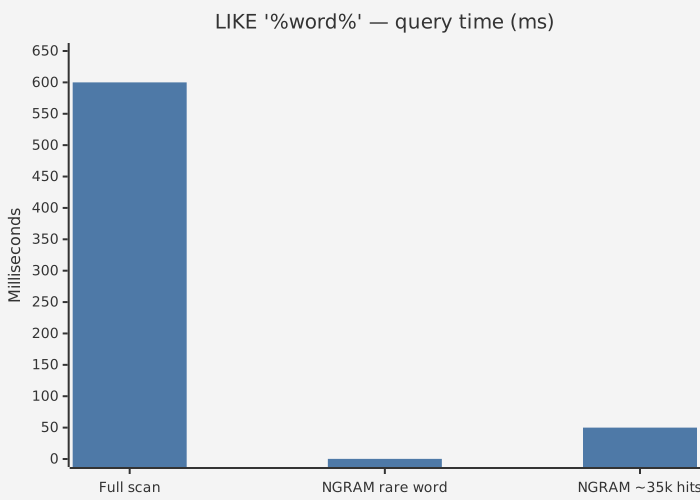
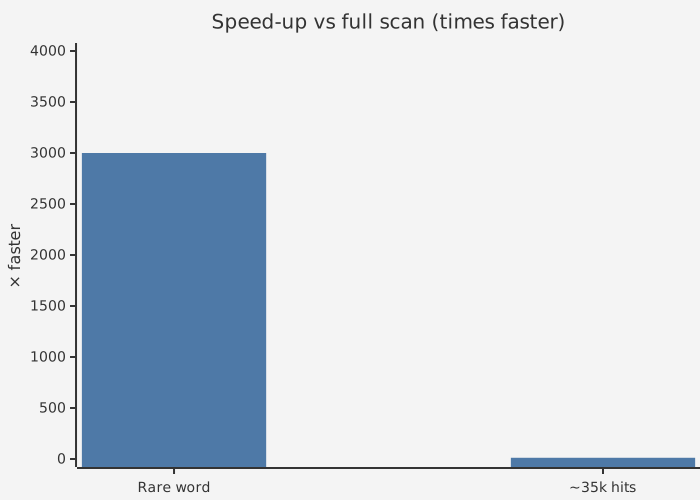
LIKE '%word%' 12 tot 4000 keer sneller dan een volledige scan (van 0,2 ms voor zeldzame woorden
tot 50 ms voor een woord in 35 000 rijen, tegen 600 ms voor de scan).
Met UNICODE_CI_AI is de scan 6 keer langzamer (3,5 s), de index niet:
LIKE en CONTAINING zijn 20 tot 8000 keer sneller.
- Ongeveer 1,4 indexvermeldingen per teken tekst (elke vermelding is een 8-byte gram-hash en een recordnummer). Verwacht een index die meerdere keren groter is dan de tekst.
- Elke insert voegt ongeveer 1,4 B-tree-vermeldingen per teken toe: inserts in een tabel met een NGRAM-index zijn veel langzamer dan zonder. Het doel is voornamelijk append-gegevens (logs, berichten, documenten) met zeldzame updates.
- Updates voegen alleen de nieuwe grams in. Oude grams worden verwijderd door garbage collection wanneer geen recordversie ze meer nodig heeft.
- Het aanmaken van de index laat 5% vrije ruimte in elke pagina, zoals
CONCURRENTLYdoet. De grams van één record staan in veel bladpagina’s; zonder vrije ruimte splitsen de eerste updates na het aanmaken bijna elke bladpagina. - Een
UPDATEdie de geïndexeerde kolom niet wijzigt (voor een index op een expressie: de kolommen die de expressie gebruikt) berekent helemaal geen grams. - Voor een bulkload maakt u de index na het laden, of maakt u hem
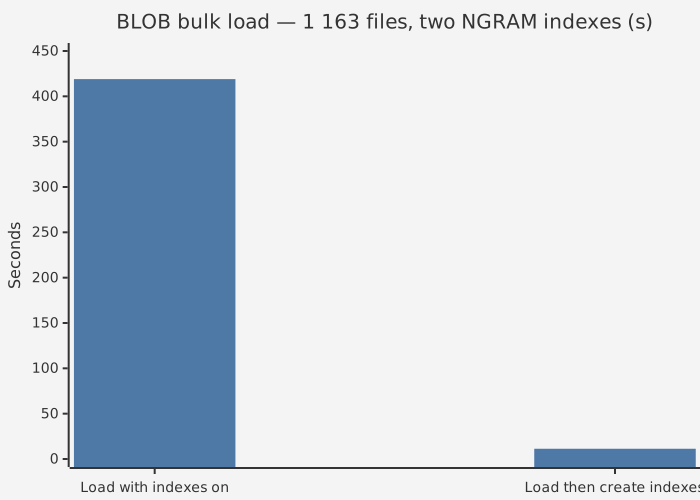
INACTIVEtijdens het laden. 1 163 bronbestanden (28 miljoen tekens) als BLOBs: laden met twee NGRAM-indexen 419 s; laden zonder indexen 0,6 s, daarna het aanmaken van beide indexen 10,7 s. - Het aanmaken van de index sorteert alle grams: tijdelijke ruimte is ongeveer 20 bytes per gram.
ParallelWorkersversnelt het aanmaken.
Compatibiliteit met servers zonder NGRAM-ondersteuning
De index wordt opgeslagen in ODS 13.1. De voorwaarde (RDB$CONDITION_BLR) begint met een guard-
expressie die mislukt met een conversiefout. Een server zonder NGRAM-ondersteuning
(standaard Firebird 5.0.x, oudere HQbird):
- opent de database;
SELECTgeeft juiste resultaten en gebruikt de NGRAM-index niet; - weigert
INSERTenUPDATEin de tabel met de foutconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(zodat de index nooit beschadigd raakt); - staat
DELETEen sweep toe (de index behoudt extra vermeldingen: alleen een kostprijs in grootte);
- kan de index niet activeren.
Getest met standaard Firebird 5.0.4.1812 en HQbird 5.0.4.1773.
Tools van derden kunnen de index tonen als DESCENDING met een WHERE-clausule.
gbak maakt back-ups van en herstelt NGRAM-indexen (het herstel moet worden gedaan door HQbird met NGRAM-ondersteuning).
Een standaardherstel mislukt op een NGRAM-index op een BLOB-kolom (attempt to index BLOB column)
en laat de database offline (gfix -online brengt hem online zonder die index).