NGRAM 인덱스 (HQbird): LIKE '%...%' 및 CONTAINING을 사용한 부분 문자열 검색
NGRAM 인덱스는 텍스트 값의 부분 문자열로 행을 찾으므로,
WHERE col LIKE '%error 404%'가 전체 테이블을 읽을 필요가 없습니다.
이는 GitHub 코드 검색의 방식인 희소 n-그램(sparse n-grams) 을 사용합니다
(구현은 SereneDB를 따릅니다).
구문
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- 하나의
CHAR,VARCHAR또는BLOB SUB_TYPE TEXT컬럼, 또는 텍스트 또는 텍스트 BLOB 결과를 갖는 표현식. - 모든 문자 집합과 콜레이션이 허용되며, 대소문자 및 악센트 무시
(
UNICODE_CI,UNICODE_CI_AI) 및 ICU 콜레이션(로케일이 있는UNICODE,UTF8)도 포함됩니다. - 부분 인덱스(
WHERE)는 쿼리에 동일한 조건이 있을 때만 사용됩니다. - 허용되지 않음:
UNIQUE,DESCENDING, 여러 컬럼,CONCURRENTLY, 바이너리 BLOB, 배열. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEX는 평소와 같이 동작합니다.SHOW INDEX는NGRAM INDEX를 출력하고,isql -x는CREATE NGRAM INDEX를 출력합니다.- 데이터베이스 ODS는 13.1이어야 합니다 (Firebird 5의 기본값).
인덱스를 사용하는 쿼리
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- 패턴이 매개변수인 경우
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- COMPUTED BY (UPPER(col)) 인덱스 사용 시
SELECT ... WHERE col CONTAINING 'needle';     -- 아래 "CONTAINING" 참조
- 패턴에는 최소 3자 이상의 리터럴 부분(
%와_사이)이 있어야 합니다. 그러한 부분이 없는 상수 패턴은 인덱스를 사용하지 않습니다. 그러한 부분이 없는 매개변수는 전체 스캔을 수행합니다 (결과는 여전히 정확합니다). - 인덱스는 다른 인덱스와 결합될 수 있습니다 (
AND). LIKE는 찾은 모든 행에 대해 항상 다시 검사되므로, 인덱스가 쿼리 결과를 변경하는 일은 없습니다.- 여러
LIKE의OR는 각각에 대해 인덱스를 사용합니다. - 다음에는 사용되지 않음:
SIMILAR TO,STARTING WITH,=, 범위,IS NULL,ORDER BY,MIN/MAX.
콜레이션
인덱스 키는 LIKE가 비교하는 것과 동일한 텍스트의 정규 형식으로 만들어집니다.
따라서 대소문자 무시 콜레이션에서는 LIKE가 대소문자를 무시하며, 인덱스는
동일한 행을 찾습니다:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- 'Café', 'CAFE', 'café'를 찾음
ICU 콜레이션의 정규 형식은 일반 인덱스와 마찬가지로 ICU 버전에 따라 달라집니다.
ICU 라이브러리가 변경된 후에는 인덱스를 재구축하십시오
(ALTER INDEX ... INACTIVE, 그 다음 ACTIVE).
CONTAINING
col CONTAINING 'x'는 대소문자를 무시합니다. 다음 두 경우에 NGRAM 인덱스를 사용합니다:
col이 대소문자 무시 유니코드 콜레이션(UNICODE_CI,UNICODE_CI_AI)을 가진UTF8인 경우: 컬럼 자체에 대한 인덱스;- 그 외의 콜레이션:
COMPUTED BY (UPPER(col))인덱스. 쿼리는 평소처럼col CONTAINING 'x'로 작성하십시오: 옵티마이저가UPPER인덱스를 스스로 찾습니다.
UTF8 및 UNICODE_FSS 이외의 멀티바이트 문자 집합(예: SJIS_0208)과 그 기본
콜레이션에는 사용되지 않습니다: 거기서는 CONTAINING이 문자 대신 바이트를 비교합니다.
텍스트 BLOB
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- note_body_up_ng 사용
- 인덱스는 길이에 관계없이 전체 BLOB의 그램을 가집니다. 서버는 64K 문자 윈도우로
그램을 만들고 고유한 그램만 유지하므로, 키를 위한 메모리는 BLOB 크기가 아니라
고유 그램 수에 따라 달라집니다. 멀티바이트 문자 집합의 BLOB은
LIKE가 읽는 것처럼 전체가 읽힙니다. - BLOB은 행이 삽입될 때, BLOB이 변경될 때, 그리고 가비지 컬렉션이 이전 버전을
제거할 때 한 번 더 읽힙니다. 다른 컬럼의
UPDATE는 동일한 BLOB을 유지하며 읽지 않습니다 (COMPUTED BY (UPPER(body))인덱스의 경우도 마찬가지). - 인덱스는 행의 각 고유 그램에 대해 하나의 항목을 가집니다. 긴 문서는 많은 그램을 반복합니다: Firebird 소스 파일은 문자당 0.3개 항목, 짧은 줄은 1.4개입니다.
- 데이터를 먼저 로드한 다음 인덱스를 생성하십시오 (“크기와 비용” 참조).
플랜 출력:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
크기와 비용
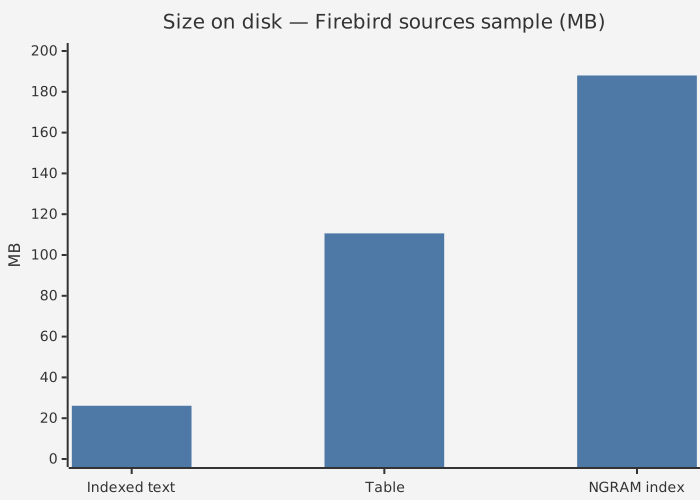
Firebird 소스 코드의 줄에서 측정 (953,000행, 2,700만 문자):
인덱스 188 MB (텍스트의 7.2배, 테이블의 1.7배), 구축 시간 16초;
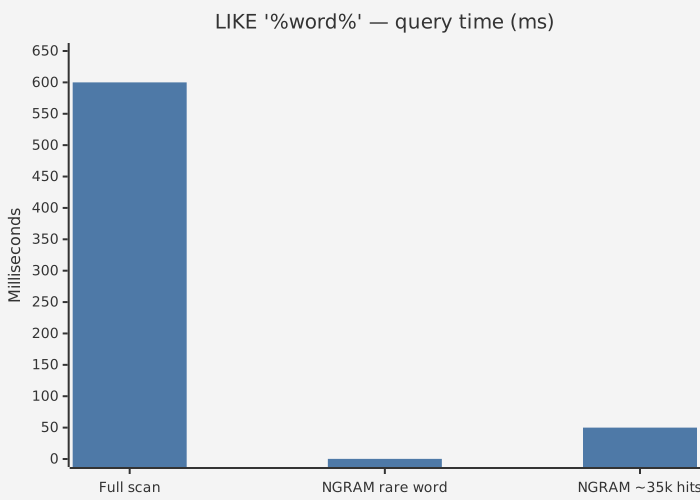
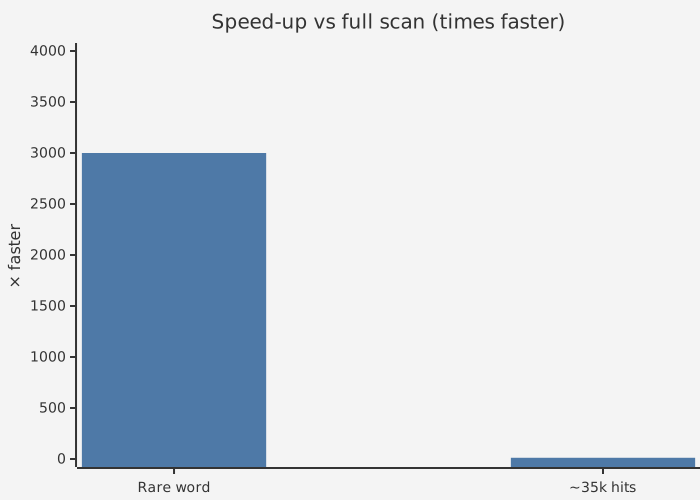
LIKE '%word%'는 전체 스캔보다 124000배 빠름 (희귀 단어의 경우 0.2 ms부터
35,000행에 있는 단어의 경우 50 ms까지, 스캔은 600 ms).
8000배 빠릅니다.UNICODE_CI_AI의 경우 스캔은 6배 느려지지만(3.5초) 인덱스는 그렇지 않습니다:
LIKE와 CONTAINING은 20
- 텍스트 문자당 약 1.4개의 인덱스 항목 (각 항목은 8바이트 그램 해시와 레코드 번호). 인덱스는 텍스트보다 몇 배 더 클 것으로 예상하십시오.
- 모든 삽입은 문자당 약 1.4개의 B-tree 항목을 추가합니다: NGRAM 인덱스가 있는 테이블에 대한 삽입은 없는 경우보다 훨씬 느립니다. 대상은 업데이트가 드문 추가 위주(append-mostly) 데이터(로그, 메시지, 문서)입니다.
- 업데이트는 새 그램만 삽입합니다. 이전 그램은 더 이상 어떤 레코드 버전도 필요로 하지 않을 때 가비지 컬렉션에 의해 제거됩니다.
- 인덱스 생성은
CONCURRENTLY와 마찬가지로 각 페이지에 5%의 여유 공간을 남깁니다. 한 레코드의 그램은 많은 리프 페이지에 분산됩니다; 여유 공간이 없으면 생성 직후의 첫 업데이트가 거의 모든 리프 페이지를 분할합니다. - 인덱싱된 컬럼(표현식에 대한 인덱스의 경우: 표현식이 사용하는 컬럼)을 변경하지 않는
UPDATE는 그램을 전혀 계산하지 않습니다. - 대량 로드의 경우 로드 후에 인덱스를 생성하거나, 로드 중에
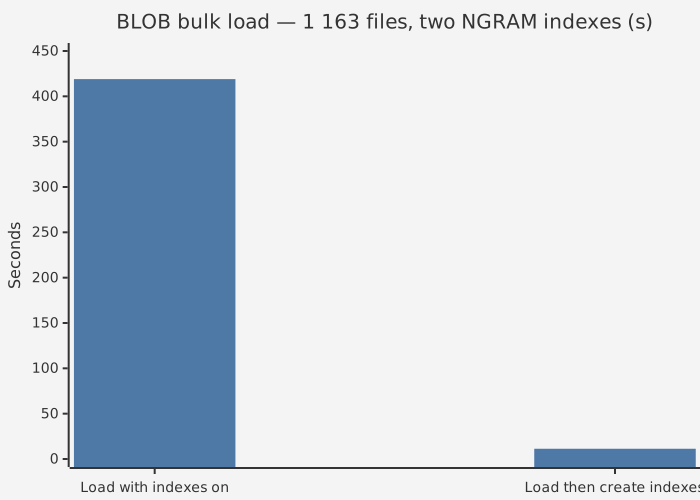
INACTIVE로 만드십시오. BLOB으로서 1,163개의 소스 파일(2,800만 문자): 두 개의 NGRAM 인덱스와 함께 로드 시 419초; 인덱스 없이 로드 시 0.6초, 그 다음 두 인덱스 생성에 10.7초. - 인덱스 생성은 모든 그램을 정렬합니다: 임시 공간은 그램당 약 20바이트입니다.
ParallelWorkers가 생성을 가속합니다.
NGRAM을 지원하지 않는 서버와의 호환성
인덱스는 ODS 13.1에 저장됩니다. 인덱스의 조건(RDB$CONDITION_BLR)은 변환 오류로
실패하는 가드 표현식으로 시작합니다. NGRAM을 지원하지 않는 서버
(순정 Firebird 5.0.x, 이전 HQbird):
- 데이터베이스를 엽니다;
SELECT는 올바른 결과를 제공하며 NGRAM 인덱스를 사용하지 않습니다; - 테이블에 대한
INSERT및UPDATE를 오류conversion error from string "HQBIRD NGRAM INDEX: use HQbird server"와 함께 거부합니다 (따라서 인덱스는 절대 손상되지 않습니다); DELETE와 sweep을 허용합니다 (인덱스는 추가 항목을 유지합니다: 크기 비용만 발생);
- 인덱스를 활성화할 수 없습니다.
순정 Firebird 5.0.4.1812 및 HQbird 5.0.4.1773으로 테스트되었습니다.
타사 도구는 인덱스를 WHERE 절이 있는 DESCENDING으로 표시할 수 있습니다.
gbak은 NGRAM 인덱스를 백업 및 복원합니다 (복원은 NGRAM을 지원하는 HQbird로 수행해야 합니다).
순정 복원은 BLOB 컬럼의 NGRAM 인덱스에서 실패하며(attempt to index BLOB column)
데이터베이스를 오프라인 상태로 남깁니다 (gfix -online은 해당 인덱스 없이 온라인으로 전환합니다).