NGRAMインデックス(HQbird):LIKE '%...%' と CONTAINING による部分文字列検索
NGRAMインデックスはテキスト値の部分文字列によって行を検索するため、
WHERE col LIKE '%error 404%' がテーブル全体を読み取る必要がありません。
これはスパースn-gramを使用しており、GitHubコード検索の手法です
(実装はSereneDBに従っています)。
構文
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- 1つの
CHAR、VARCHAR、またはBLOB SUB_TYPE TEXTカラム、あるいはテキスト またはテキストBLOBを結果とする式。 - すべての文字セットと照合順序が許可され、大文字小文字とアクセントを区別しないもの
(
UNICODE_CI、UNICODE_CI_AI)やICU照合順序(ロケール付きのUNICODE、UTF8)も含まれます。 - 部分インデックス(
WHERE)は、クエリが同じ条件を持つ場合にのみ使用されます。 - 許可されないもの:
UNIQUE、DESCENDING、複数カラム、CONCURRENTLY、バイナリBLOB、配列。 ALTER INDEX ... ACTIVE | INACTIVE、SET STATISTICS INDEX、DROP INDEXは通常どおり動作します。SHOW INDEXはNGRAM INDEXを出力し、isql -xはCREATE NGRAM INDEXを出力します。- データベースのODSは13.1である必要があります(Firebird 5のデフォルト)。
インデックスを使用するクエリ
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- パターンはパラメータ
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- COMPUTED BY (UPPER(col)) のインデックスを使用
SELECT ... WHERE col CONTAINING 'needle';     -- 下記の「CONTAINING」を参照
- パターンには少なくとも3文字のリテラル部分(
%と_の間)が必要です。 そのような部分を持たない定数パターンはインデックスを使用しません。 そのような部分を持たないパラメータはフルスキャンになります(結果は依然として正しい)。 - インデックスは他のインデックスと組み合わせることができます(
AND)。 LIKEは見つかった各行に対して常に再チェックされるため、インデックスがクエリの 結果を変えることはありません。- 複数の
LIKEのORは、それぞれに対してインデックスを使用します。 - 以下には使用されません:
SIMILAR TO、STARTING WITH、=、範囲、IS NULL、ORDER BY、MIN/MAX。
照合順序
インデックスのキーは、LIKE が比較するのと同じテキストの正規形から作られます。
したがって、大文字小文字を区別しない照合順序では LIKE も大文字小文字を区別せず、
インデックスは同じ行を見つけます:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- 'Café'、'CAFE'、'café' を見つける
ICU照合順序の正規形は、通常のインデックスと同様にICUのバージョンに依存します。
ICUライブラリの変更後は、インデックスを再構築してください
(ALTER INDEX ... INACTIVE、次に ACTIVE)。
CONTAINING
col CONTAINING 'x' は大文字小文字を区別しません。次の2つの場合にNGRAMインデックスを使用します:
colが大文字小文字を区別しないUnicode照合順序(UNICODE_CI、UNICODE_CI_AI)を持つUTF8の場合: カラム自体のインデックス;- その他の照合順序の場合:
COMPUTED BY (UPPER(col))のインデックス。クエリは 通常どおりcol CONTAINING 'x'と書きます:オプティマイザがUPPERインデックスを自分で見つけます。
UTF8 と UNICODE_FSS 以外のマルチバイト文字セット(例えば SJIS_0208)とそのデフォルト照合順序
には使用されません:そこでは CONTAINING は文字ではなくバイトを比較します。
テキストBLOB
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- note_body_up_ng を使用
- インデックスは任意の長さのBLOB全体のグラムを持ちます。サーバーは64K文字の
ウィンドウでグラムを作り、異なるグラムのみを保持するため、キーのメモリは
BLOBのサイズではなく異なるグラムの数に依存します。マルチバイト文字セットのBLOBは、
LIKEが読み取るのと同じように全体が読み取られます。 - BLOBは行の挿入時、BLOBの変更時、そしてガベージコレクションが古いバージョンを
削除する際にもう一度読み取られます。他のカラムの
UPDATEは同じBLOBを保持し、 それを読み取りません(COMPUTED BY (UPPER(body))のインデックスでも同様)。 - インデックスは行の異なるグラムごとに1つのエントリを持ちます。長いドキュメントは 多くのグラムを繰り返します:Firebirdのソースファイルでは1文字あたり0.3エントリ、 短い行では1.4エントリです。
- まずデータをロードし、その後でインデックスを作成してください(「サイズとコスト」を参照)。
プラン出力:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
サイズとコスト
Firebirdソースコードの行で測定(953,000行、2,700万文字):
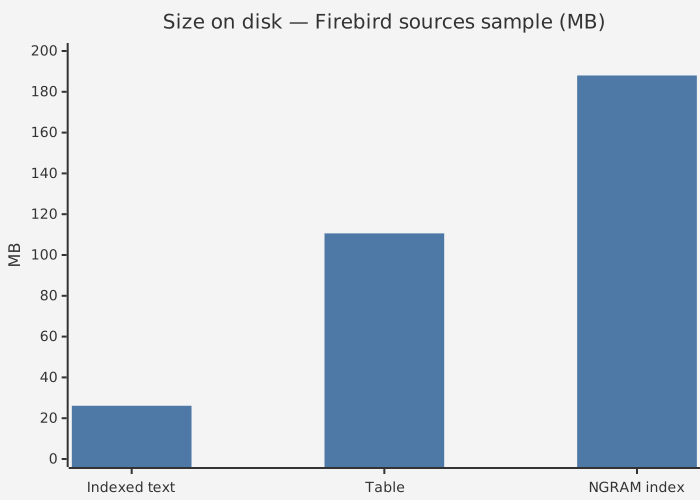
インデックス188 MB(テキストの7.2倍、テーブルの1.7倍)、構築に16秒;
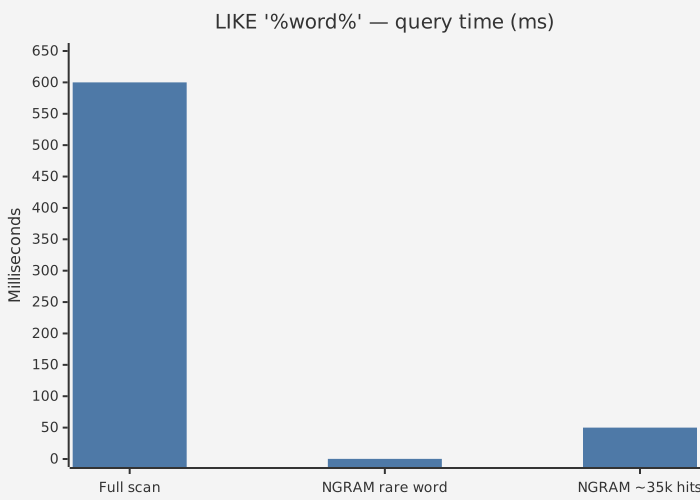
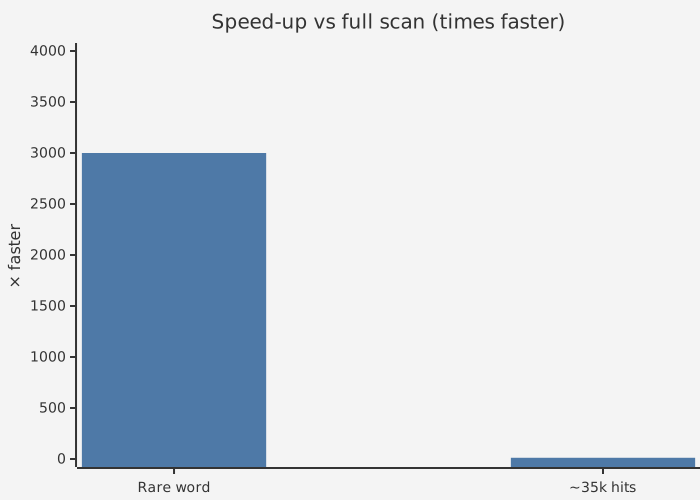
LIKE '%word%' はフルスキャンより12〜4000倍高速(珍しい単語で0.2 msから、
35,000行にある単語で50 ms、スキャンは600 ms)。
UNICODE_CI_AI ではスキャンは6倍遅く(3.5秒)、インデックスはそうではありません:
LIKE と CONTAINING は20〜8000倍高速です。
- テキスト1文字あたり約1.4インデックスエントリ(各エントリは8バイトのグラムハッシュと レコード番号)。テキストより数倍大きいインデックスを想定してください。
- 各挿入は1文字あたり約1.4のB-treeエントリを追加します:NGRAMインデックスを持つ テーブルへの挿入は、それがない場合よりはるかに遅くなります。対象は追加が主なデータ (ログ、メッセージ、ドキュメント)で、更新がまれなものです。
- 更新は新しいグラムのみを挿入します。古いグラムは、どのレコードバージョンも それらを必要としなくなったときにガベージコレクションによって削除されます。
- インデックス作成は
CONCURRENTLYと同様に各ページに5%の空き領域を残します。1つの レコードのグラムは多くのリーフページに分散します;空き領域がないと、作成後の最初の 更新がほぼすべてのリーフページを分割します。 - インデックス対象のカラム(式のインデックスの場合は式が使用するカラム)を変更しない
UPDATEは、グラムをまったく計算しません。 - 一括ロードでは、ロード後にインデックスを作成するか、ロード中に
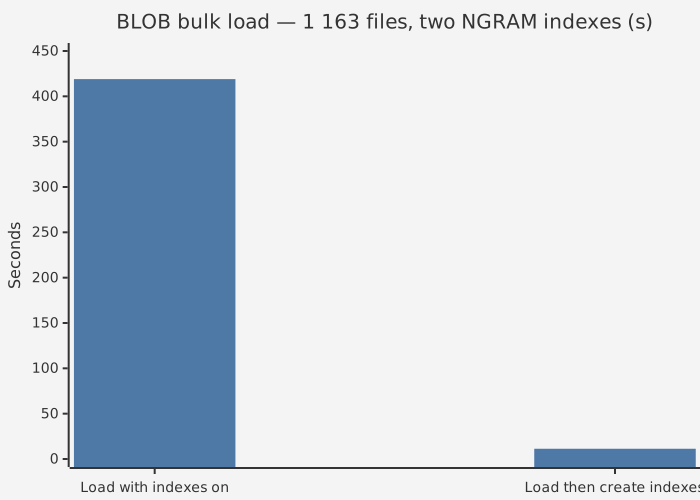
INACTIVEにしてください。 1,163のソースファイル(2,800万文字)をBLOBとして:2つのNGRAMインデックスありで ロード419秒;インデックスなしでロード0.6秒、その後両方のインデックス作成に10.7秒。 - インデックス作成はすべてのグラムをソートします:一時領域はグラムあたり約20バイトです。
ParallelWorkersが作成を高速化します。
NGRAMサポートのないサーバーとの互換性
インデックスはODS 13.1に格納されます。その条件(RDB$CONDITION_BLR)は、変換エラーで
失敗するガード式で始まります。NGRAMサポートのないサーバー(標準のFirebird 5.0.x、
古いHQbird):
- データベースを開きます;
SELECTは正しい結果を返し、NGRAMインデックスを使用しません; - テーブルへの
INSERTとUPDATEをエラーconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"で拒否します(したがってインデックスが破損することはありません); DELETEとスイープを許可します(インデックスは余分なエントリを保持します:サイズのコストのみ);
- インデックスをアクティブ化できません。
標準のFirebird 5.0.4.1812とHQbird 5.0.4.1773でテスト済み。
サードパーティのツールはインデックスを WHERE 句付きの DESCENDING として表示する場合があります。
gbakはNGRAMインデックスをバックアップおよびリストアします(リストアはNGRAMサポートのあるHQbirdで
行う必要があります)。標準のリストアは BLOB カラムのNGRAMインデックスで失敗し
(attempt to index BLOB column)、データベースをオフラインのままにします
(gfix -online はそのインデックスなしでオンラインに戻します)。