Indice NGRAM (HQbird): ricerca di sottostringhe con LIKE '%...%' e CONTAINING
Un indice NGRAM trova le righe tramite una sottostringa di un valore testuale, così che
WHERE col LIKE '%error 404%' non debba leggere l’intera tabella.
Usa n-grammi sparsi, il metodo della ricerca di codice di GitHub
(l’implementazione segue SereneDB).
Sintassi
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Una colonna
CHAR,VARCHARoBLOB SUB_TYPE TEXT, oppure un’espressione con risultato testuale o BLOB testuale. - Sono ammessi tutti i set di caratteri e le collation, anche case e accent insensitive
(
UNICODE_CI,UNICODE_CI_AI) e le collation ICU (UNICODE,UTF8con una locale). - Un indice parziale (
WHERE) è usato solo se la query ha la stessa condizione. - Non ammessi:
UNIQUE,DESCENDING, più colonne,CONCURRENTLY, BLOB binari, array. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfunzionano come al solito.SHOW INDEXstampaNGRAM INDEX,isql -xstampaCREATE NGRAM INDEX.- L’ODS del database deve essere 13.1 (il default per Firebird 5).
Query che usano l’indice
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- il pattern è un parametro
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- con un indice COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- vedi "CONTAINING" sotto
- Il pattern deve avere una parte letterale di almeno 3 caratteri (tra
%e_). Un pattern costante senza tale parte non usa l’indice. Un parametro senza tale parte dà una scansione completa (il risultato è comunque corretto). - L’indice può essere combinato con altri indici (
AND). LIKEè sempre ricontrollato per ogni riga trovata, quindi l’indice non cambia mai il risultato di una query.ORdi piùLIKEusa l’indice per ciascuno di essi.- Non usato per:
SIMILAR TO,STARTING WITH,=, intervalli,IS NULL,ORDER BY,MIN/MAX.
Collation
Le chiavi dell’indice sono fatte della stessa forma canonica del testo che LIKE confronta.
Quindi con una collation case insensitive LIKE è case insensitive, e l’indice trova
le stesse righe:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- trova 'Café', 'CAFE', 'café'
La forma canonica delle collation ICU dipende dalla versione di ICU, come per gli indici
ordinari. Dopo un cambio della libreria ICU, ricostruire l’indice
(ALTER INDEX ... INACTIVE, poi ACTIVE).
CONTAINING
col CONTAINING 'x' è case insensitive. Usa un indice NGRAM in due casi:
colèUTF8con una collation Unicode case insensitive (UNICODE_CI,UNICODE_CI_AI): un indice sulla colonna stessa;- qualsiasi altra collation: un indice
COMPUTED BY (UPPER(col)). Scrivere la query come al solito,col CONTAINING 'x': l’optimizer trova da solo l’indiceUPPER.
Non usato per set di caratteri multi-byte diversi da UTF8 e UNICODE_FSS
(per esempio SJIS_0208) con le loro collation predefinite: lì CONTAINING
confronta byte, non caratteri.
BLOB testuali
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- usa note_body_up_ng
- L’indice ha i grammi dell’intero BLOB, di qualsiasi lunghezza. Il server crea i grammi
in finestre di 64K caratteri e mantiene solo i grammi distinti, quindi la memoria per le chiavi
dipende dal numero di grammi distinti, non dalla dimensione del BLOB. Un BLOB in un set di caratteri
multi-byte è letto interamente, come lo legge
LIKE. - Il BLOB è letto quando una riga è inserita, quando il BLOB è modificato, e ancora una volta
quando la garbage collection rimuove la vecchia versione. Un
UPDATEdi altre colonne mantiene lo stesso BLOB e non lo legge (anche per un indiceCOMPUTED BY (UPPER(body))). - L’indice ha una voce per ogni grammo distinto di una riga. I documenti lunghi ripetono molti grammi: i file sorgente di Firebird danno 0,3 voci per carattere, le righe corte 1,4.
- Caricare prima i dati, poi creare l’indice (vedi “Dimensione e costo”).
Output del plan:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Dimensione e costo
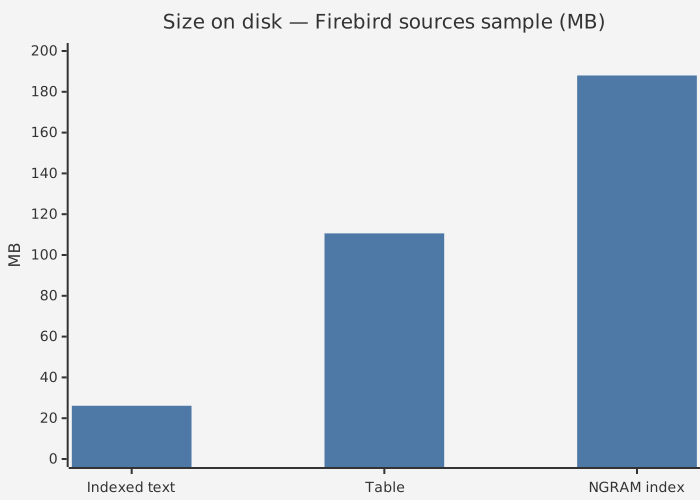
Misurato sulle righe del codice sorgente di Firebird (953 000 righe, 27 milioni di caratteri):
indice 188 MB (7,2 x il testo, 1,7 x la tabella), creato in 16 s;
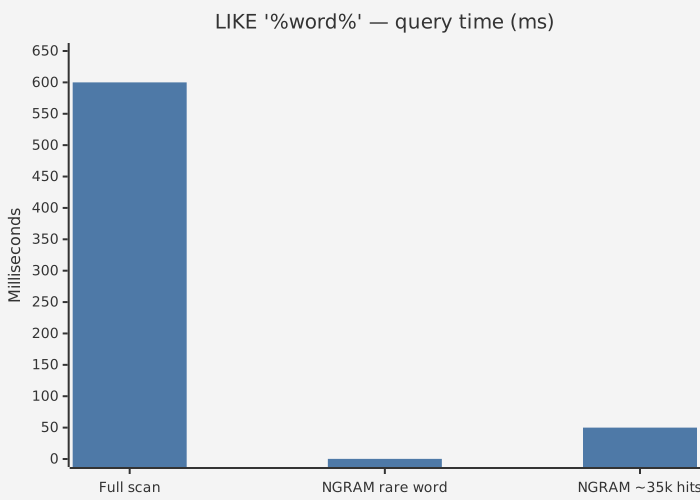
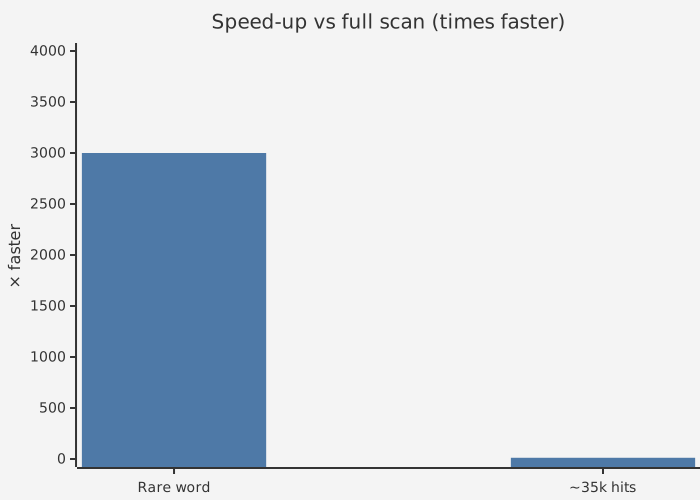
LIKE '%word%' da 12 a 4000 volte più veloce di una scansione completa (da 0,2 ms per parole rare
a 50 ms per una parola presente in 35 000 righe, contro 600 ms per la scansione).
Con UNICODE_CI_AI la scansione è 6 volte più lenta (3,5 s), l’indice no:
LIKE e CONTAINING sono da 20 a 8000 volte più veloci.
- Circa 1,4 voci di indice per carattere di testo (ogni voce è un hash del grammo di 8 byte e un numero di record). Aspettarsi un indice diverse volte più grande del testo.
- Ogni insert aggiunge circa 1,4 voci B-tree per carattere: gli insert in una tabella con un indice NGRAM sono molto più lenti che senza. L’obiettivo sono dati prevalentemente in append (log, messaggi, documenti) con aggiornamenti rari.
- Gli update inseriscono solo i nuovi grammi. I vecchi grammi sono rimossi dalla garbage collection quando nessuna versione di record ne ha più bisogno.
- La creazione dell’indice lascia il 5% di spazio libero in ogni pagina, come fa
CONCURRENTLY. I grammi di un record sono in molte pagine foglia; senza spazio libero i primi update dopo la creazione dividono quasi ogni pagina foglia. - Un
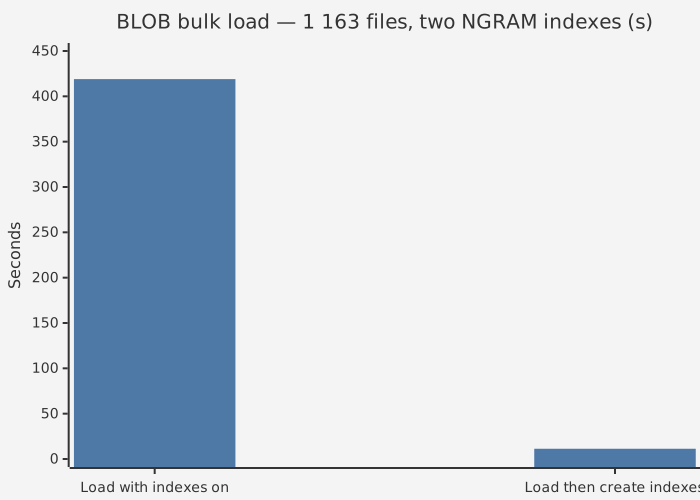
UPDATEche non cambia la colonna indicizzata (per un indice su un’espressione: le colonne che l’espressione usa) non calcola affatto i grammi. - Per un caricamento massivo, creare l’indice dopo il caricamento, oppure renderlo
INACTIVEdurante il caricamento. 1 163 file sorgente (28 milioni di caratteri) come BLOB: caricamento con due indici NGRAM 419 s; caricamento senza indici 0,6 s, poi creazione di entrambi gli indici 10,7 s. - La creazione dell’indice ordina tutti i grammi: lo spazio temporaneo è di circa 20 byte per grammo.
ParallelWorkersvelocizza la creazione.
Compatibilità con server senza supporto NGRAM
L’indice è memorizzato in ODS 13.1. La sua condizione (RDB$CONDITION_BLR) inizia con un’espressione
di guardia che fallisce con un errore di conversione. Un server senza supporto NGRAM
(Firebird 5.0.x stock, HQbird più vecchi):
- apre il database;
SELECTdà risultati corretti e non usa l’indice NGRAM; - rifiuta
INSERTeUPDATEnella tabella con l’erroreconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(così l’indice non viene mai corrotto); - consente
DELETEe sweep (l’indice mantiene voci in più: solo un costo in dimensione);
- non può attivare l’indice.
Testato con Firebird 5.0.4.1812 stock e HQbird 5.0.4.1773.
Strumenti di terze parti possono mostrare l’indice come DESCENDING con una clausola WHERE.
gbak esegue backup e restore degli indici NGRAM (il restore deve essere fatto da HQbird con supporto NGRAM).
Un restore stock fallisce su un indice NGRAM su una colonna BLOB (attempt to index BLOB column)
e lascia il database offline (gfix -online lo riporta online senza quell’indice).