NGRAM-Index (HQbird): Teilstringsuche mit LIKE '%...%' und CONTAINING
Ein NGRAM-Index findet Zeilen anhand eines Teilstrings eines Textwerts, sodass
WHERE col LIKE '%error 404%' nicht die gesamte Tabelle lesen muss.
Er verwendet sparse n-grams, die Methode der GitHub-Codesuche
(die Implementierung folgt SereneDB).
Syntax
CREATE NGRAM INDEX name ON table (column);
CREATE NGRAM INDEX name ON table COMPUTED BY (expression);
CREATE NGRAM INDEX name ON table (column) WHERE condition;
- Eine Spalte vom Typ
CHAR,VARCHARoderBLOB SUB_TYPE TEXToder ein Ausdruck mit einem Text- oder Text-BLOB-Ergebnis. - Jeder Zeichensatz und jede Collation ist erlaubt, auch case- und akzentunabhängig
(
UNICODE_CI,UNICODE_CI_AI) und ICU-Collations (UNICODE,UTF8mit einem Locale). - Ein partieller Index (
WHERE) wird nur verwendet, wenn die Abfrage dieselbe Bedingung hat. - Nicht erlaubt:
UNIQUE,DESCENDING, mehrere Spalten,CONCURRENTLY, binäre BLOBs, Arrays. ALTER INDEX ... ACTIVE | INACTIVE,SET STATISTICS INDEX,DROP INDEXfunktionieren wie gewohnt.SHOW INDEXgibtNGRAM INDEXaus,isql -xgibtCREATE NGRAM INDEXaus.- Die Datenbank-ODS muss 13.1 sein (der Standard für Firebird 5).
Abfragen, die den Index verwenden
SELECT ... WHERE col LIKE '%needle%';
SELECT ... WHERE col LIKE '%part1%part2%';
SELECT ... WHERE col LIKE 'pre_fix%' ESCAPE '\';
SELECT ... WHERE col LIKE ?;                   -- the pattern is a parameter
SELECT ... WHERE UPPER(col) LIKE '%NEEDLE%';  -- with an index COMPUTED BY (UPPER(col))
SELECT ... WHERE col CONTAINING 'needle';     -- see "CONTAINING" below
- Das Muster muss einen Literalteil von mindestens 3 Zeichen haben (zwischen
%und_). Ein konstantes Muster ohne einen solchen Teil verwendet den Index nicht. Ein Parameter ohne einen solchen Teil führt zu einem Full Scan (das Ergebnis ist trotzdem korrekt). - Der Index kann mit anderen Indizes kombiniert werden (
AND). LIKEwird für jede gefundene Zeile erneut geprüft, sodass der Index niemals das Ergebnis einer Abfrage verändert.ORaus mehrerenLIKEverwendet den Index für jedes davon.- Nicht verwendet für:
SIMILAR TO,STARTING WITH,=, Bereiche,IS NULL,ORDER BY,MIN/MAX.
Collations
Die Indexschlüssel werden aus derselben kanonischen Form des Textes gebildet, die LIKE vergleicht.
Bei einer case-insensitiven Collation ist LIKE also case-insensitiv, und der Index findet
dieselben Zeilen:
CREATE TABLE doc (id INT, title VARCHAR(200) CHARACTER SET UTF8 COLLATE UNICODE_CI_AI);
CREATE NGRAM INDEX doc_title_ng ON doc (title);
SELECT id FROM doc WHERE title LIKE '%cafe%';   -- finds 'Café', 'CAFE', 'café'
Die kanonische Form von ICU-Collations hängt von der ICU-Version ab, wie bei gewöhnlichen
Indizes. Nach einem Wechsel der ICU-Bibliothek muss der Index neu aufgebaut werden
(ALTER INDEX ... INACTIVE, dann ACTIVE).
CONTAINING
col CONTAINING 'x' ist case-insensitiv. Es verwendet einen NGRAM-Index in zwei Fällen:
colistUTF8mit einer case-insensitiven Unicode-Collation (UNICODE_CI,UNICODE_CI_AI): ein Index auf der Spalte selbst;- jede andere Collation: ein Index
COMPUTED BY (UPPER(col)). Schreiben Sie die Abfrage wie gewohnt,col CONTAINING 'x': Der Optimizer findet denUPPER-Index selbst.
Nicht verwendet für Multibyte-Zeichensätze außer UTF8 und UNICODE_FSS
(zum Beispiel SJIS_0208) mit ihren Standard-Collations: Dort vergleicht CONTAINING
Bytes, nicht Zeichen.
Text-BLOBs
CREATE TABLE note (id INT, body BLOB SUB_TYPE TEXT CHARACTER SET UTF8);
CREATE NGRAM INDEX note_body_ng ON note (body);
CREATE NGRAM INDEX note_body_up_ng ON note COMPUTED BY (UPPER(body));
SELECT id FROM note WHERE body LIKE '%timeout%';
SELECT id FROM note WHERE body CONTAINING 'Timeout';  -- uses note_body_up_ng
- Der Index enthält die Gramme des gesamten BLOBs, beliebiger Länge. Der Server bildet die Gramme
in Fenstern von 64K Zeichen und behält nur unterschiedliche Gramme, sodass der Speicher für die Schlüssel
von der Anzahl der unterschiedlichen Gramme abhängt, nicht von der BLOB-Größe. Ein BLOB in einem Multibyte-
Zeichensatz wird vollständig gelesen, so wie
LIKEihn liest. - Der BLOB wird gelesen, wenn eine Zeile eingefügt wird, wenn der BLOB geändert wird, und noch einmal,
wenn die Garbage Collection die alte Version entfernt. Ein
UPDATEanderer Spalten behält denselben BLOB und liest ihn nicht (auch für einen IndexCOMPUTED BY (UPPER(body))). - Der Index hat einen Eintrag für jedes unterschiedliche Gramm einer Zeile. Lange Dokumente wiederholen viele Gramme: Die Quelldateien von Firebird ergeben 0,3 Einträge pro Zeichen, kurze Zeilen 1,4.
- Laden Sie zuerst die Daten und erstellen Sie dann den Index (siehe „Größe und Kosten").
Plan-Ausgabe:
PLAN (MSG INDEX (MSG_TEXT_NG))

Select Expression
    -> Filter
        -> Table "MSG" Access By ID
            -> Bitmap
                -> Index "MSG_TEXT_NG" N-gram Scan
Größe und Kosten
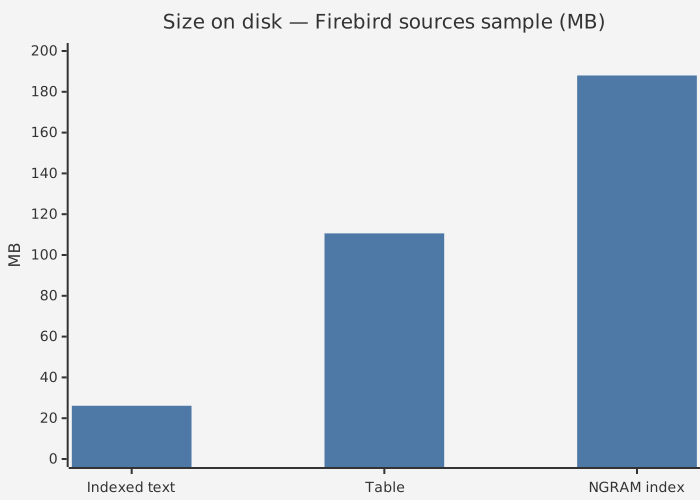
Gemessen an den Zeilen des Firebird-Quellcodes (953 000 Zeilen, 27 Millionen Zeichen):
Index 188 MB (7,2 x der Text, 1,7 x die Tabelle), aufgebaut in 16 s;
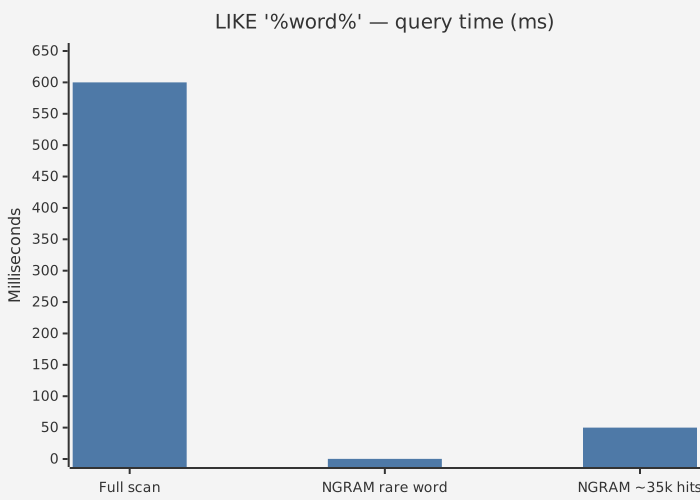
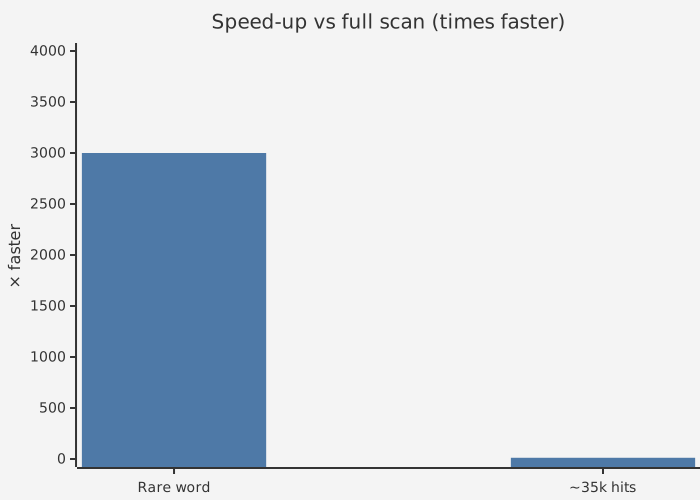
LIKE '%word%' 12- bis 4000-mal schneller als ein Full Scan (von 0,2 ms für seltene Wörter
bis 50 ms für ein Wort in 35 000 Zeilen, gegenüber 600 ms für den Scan).
Mit UNICODE_CI_AI ist der Scan 6-mal langsamer (3,5 s), der Index nicht:
LIKE und CONTAINING sind 20- bis 8000-mal schneller.
- Etwa 1,4 Indexeinträge pro Zeichen Text (jeder Eintrag ist ein 8-Byte-Gramm-Hash und eine Satznummer). Erwarten Sie einen Index, der mehrere Male größer als der Text ist.
- Jedes Einfügen fügt etwa 1,4 B-Tree-Einträge pro Zeichen hinzu: Einfügungen in eine Tabelle mit einem NGRAM-Index sind viel langsamer als ohne. Das Ziel sind überwiegend angehängte Daten (Logs, Nachrichten, Dokumente) mit seltenen Updates.
- Updates fügen nur die neuen Gramme ein. Alte Gramme werden durch die Garbage Collection entfernt, wenn keine Satzversion sie mehr benötigt.
- Die Indexerstellung lässt 5 % freien Platz in jeder Seite, wie
CONCURRENTLY. Die Gramme eines Satzes liegen in vielen Blattseiten; ohne freien Platz teilen die ersten Updates nach der Erstellung fast jede Blattseite. - Ein
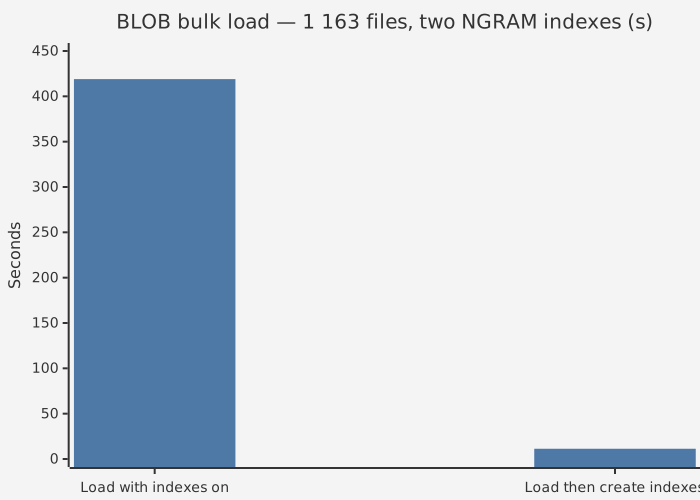
UPDATE, das die indizierte Spalte nicht ändert (bei einem Index auf einem Ausdruck: die Spalten, die der Ausdruck verwendet), berechnet überhaupt keine Gramme. - Für einen Massenimport erstellen Sie den Index nach dem Import oder machen Sie ihn während des Imports
INACTIVE. 1 163 Quelldateien (28 Millionen Zeichen) als BLOBs: Import mit zwei NGRAM-Indizes 419 s; Import ohne Indizes 0,6 s, dann Erstellung beider Indizes 10,7 s. - Die Indexerstellung sortiert alle Gramme: Der temporäre Speicher beträgt etwa 20 Bytes pro Gramm.
ParallelWorkersbeschleunigt die Erstellung.
Kompatibilität mit Servern ohne NGRAM-Unterstützung
Der Index wird in ODS 13.1 gespeichert. Seine Bedingung (RDB$CONDITION_BLR) beginnt mit einem Guard-
Ausdruck, der mit einem Konvertierungsfehler fehlschlägt. Ein Server ohne NGRAM-Unterstützung
(Stock-Firebird 5.0.x, älteres HQbird):
- öffnet die Datenbank;
SELECTliefert richtige Ergebnisse und verwendet den NGRAM-Index nicht; - verweigert
INSERTundUPDATEin die Tabelle mit dem Fehlerconversion error from string "HQBIRD NGRAM INDEX: use HQbird server"(sodass der Index niemals beschädigt wird); - erlaubt
DELETEund Sweep (der Index behält zusätzliche Einträge: nur ein Größenaufwand);
- kann den Index nicht aktivieren.
Getestet mit Stock-Firebird 5.0.4.1812 und HQbird 5.0.4.1773.
Drittanbieter-Tools zeigen den Index möglicherweise als DESCENDING mit einer WHERE-Klausel an.
gbak sichert NGRAM-Indizes und stellt sie wieder her (die Wiederherstellung muss von HQbird mit NGRAM-Unterstützung durchgeführt werden).
Eine Stock-Wiederherstellung schlägt bei einem NGRAM-Index auf einer BLOB-Spalte fehl (attempt to index BLOB column)
und lässt die Datenbank offline (gfix -online bringt sie ohne diesen Index wieder online).